前回記事【ディープラーニングで錠剤・カプセル識別システムを自作する(4)ー物理性状照合・システム統合ー】からの続きです。今回はこの自作の識別システムを使って実験や試してみたことの結果について書いていきたいと思います。
学習データにない未知の薬を見せてみる
DML(深層距離学習)を採用した理由のひとつは、知らないものは知らないと答えられることでした。そこで学習に使っていない薬(上から4番目はフリスク)を実際に見せてみて、すべてが「未特定」として返るかを確認してみました。
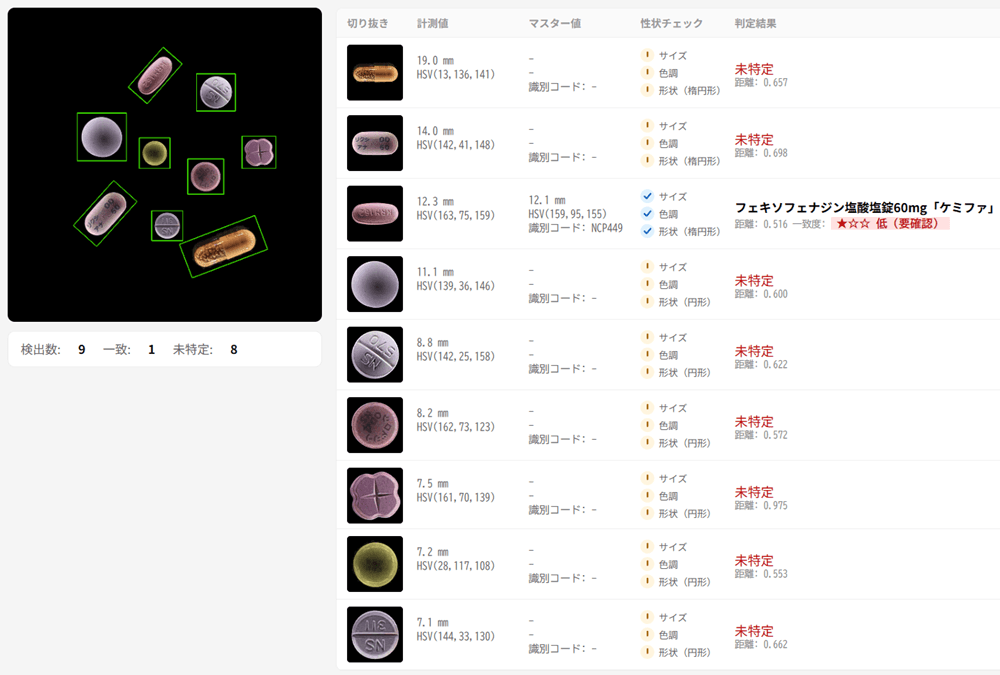
結果は9種類中8種類で期待通り「未特定」でしたが、一つは惜しくも「要確認」となりました。
この1種類については、最近傍のクラスとの距離が0.516で、設定した閾値(THRESHOLD_UNKNOWN = 0.520)との差は0.004でした。判定が未確定となる一歩手前でしたが、データセット内の既知薬剤名を「要確認」として返しています。

この薬は間違えて返してしまった既知の薬剤とは刻印こそ違うものの、サイズ・色・形状がほぼ一致しており、難しかったというのは納得がいきます。しかし逆に言うと、刻印の違いだけでも距離がこれだけ離れており、きちんと刻印(模様)を見て識別しているということがわかります。

通常の画像分類(CNN + Softmax)では、学習していない薬を見せても必ずいずれかのクラス名を返します。DMLでは最近傍クラスまでの距離が設定した閾値を超えた場合に一致なしとできるため、上のような挙動が実現できます。
もちろん完全に保証されているわけではなく、この一例のように学習済みクラスと外観が非常に似た未知薬剤は、距離が閾値以内に収まって誤って既知クラスとして判定される可能性があるため、閾値の設定は慎重に行う必要があります。
似ている錠剤・カプセルでも識別できるか
上の例が既にそうですが、他にも外観が似ている薬でどうなるかいくつか試してみました。
ここでの画像も、データセットにある種類のものでも別個体である新品を使っています。

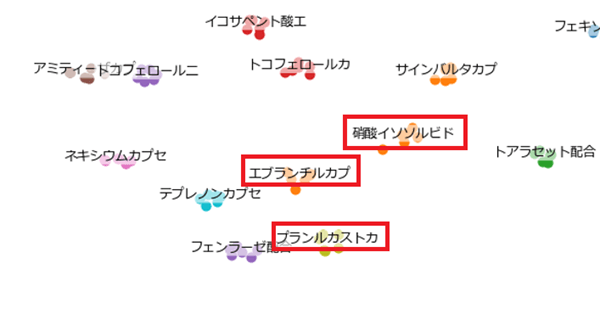
まずは白色ベースのカプセル3種類です。新品のためデータセットのマスター値とは色調でひっかかっていますが、DMLは正しい結果を返しています。真ん中の薬は角度によって印字の見え方が変わる薬のためか、距離はやや大きくなっています。
下図はt-SNEで可視化した結果です(t-SNEの詳細は第3回をご参照ください)。これらの塊は隣接した位置にあり、視覚的にも難しいことが見て取れます。
下は刻印のメーカーマークが同じ錠剤3種です。色違いはわかるとしても、白色で数字だけが違うものでもちゃんと判定できていました(ここもやや距離は大きめ)。t-SNEでも白の錠剤2つは近い位置にはありましたが、混ざることなく分離されていました。

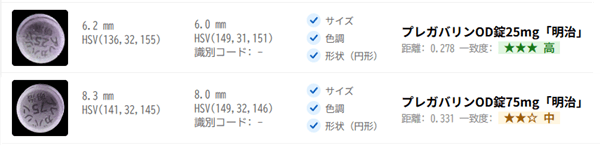
個人的には、下のような同成分で規格違い(25mgと75mg)の薬画像の識別は難しいだろうと思っていました。交差検証での誤分類でもときどき上がっていた難しいペアの例ですが、識別できています。このような例でも、データセットで最初から新品を使っていれば、もっときれいに判定できていたのではと思います。
新旧品両方の外観に対応させる
今回データセットには落下や期限切れ等で廃棄処分になった錠剤・カプセルを使用しました。なかには製造から数年が経過して表面が目に見えて劣化しているものもあり、同じ薬品の新品(データセットとは別個体)を判定させると上で挙げたように距離が大きくなってしまうケースがありました。
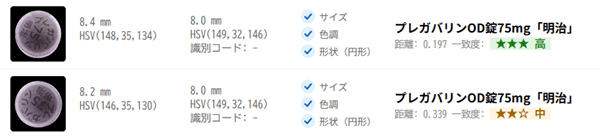
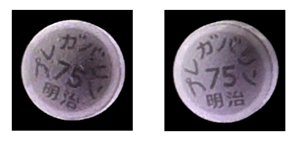 データセットに使った左の錠剤は経年劣化のため肉眼ではやや薄黄色く見え、印字・表面の一部はかすれています。右は新品です。
判定では正しい結果を返していますが「新品」の距離は0.339とやや大きく、一致度は「中」でした。
また、前回記事でも示しましたが、薬によっては新デザインになって少しだけ識別コード等のデザインが変わるケースもあります。
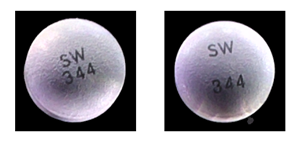 旧品(左)と現行品(右)でのデザイン変更例。
データセットには旧品を使用した上で、右の新品を判定させてみました。
識別コードの印字されている位置がほんの少し違うだけですが、判定結果は未特定となりました。
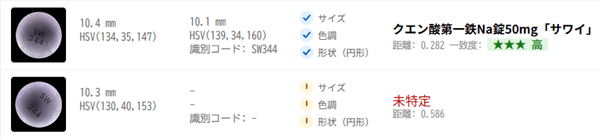
通常のCNNであれば、新デザインの薬を認識させるためにはデータセットに画像を加えて、モデル全体を再学習する必要がありましたが、DMLではこのようなときでも再学習することなく対応することができます。
モデルは既に、距離が意味を持つ埋め込み空間への変換を学習済みであるため、新品画像のembeddingを同じ薬品名としてDBに追加登録を行うだけで済みます。また、このembeddingも同じ空間に配置されるため、既存クラスの判定には影響を与えません。
今回の1対多のDB設計では1つの薬品名に複数のembeddingを持てるようにしており、推論時は複数あるembeddingとの距離の最小値を採用するよう実装しています。
手順としては以下の2つです。
- 学習済みモデルで新規画像からembeddingを計算
- DBのpill_specsテーブルに同じ薬品名で新規レコードを追加
    # 画像を全て読み込んでembeddingを計算
    embs = []
    for p in img_paths:
        img = Image.open(p).convert("RGB")
        emb = dml.get_embedding(img)   # shape: [128]
        embs.append(emb)

    # 複数枚あれば平均して再正規化(1枚でもOK)
    proto = F.normalize(
        torch.stack(embs).mean(dim=0), p=2, dim=0
    )
    blob = proto.cpu().numpy().tobytes()

    ### drugsテーブルに登録(省略) ###

    # pill_specsに登録(既存レコードに追記)
    conn.execute("""
        INSERT INTO pill_specs
            (drug_id, shape, size_mm, h_mean, s_mean, v_mean, code, embedding)
        VALUES (?, ?, ?, ?, ?, ?, ?, ?)
    """, (drug_id, shape, size_mm, h_mean, s_mean, v_mean, code, blob))
    conn.commit()
実際にこれらの作業を行い、上で撮った全く同じ画像を再度判定させてみました。
(新品の個体は同じもので別画像を1枚用意してembeddingを出しました)
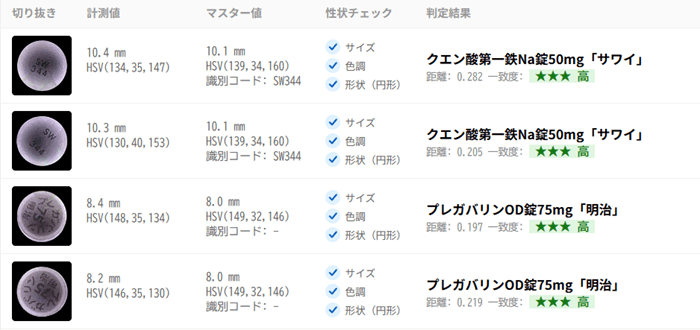
これでどちらにも対応できるようになりました。
CNN(画像分類)との違い
DMLと同じデータセット・同じバックボーン(ResNet18)で、データセットはtrain / val / testの3分割とし、EarlyStoppingを加えて通常の画像分類(CrossEntropyLoss + Softmax)でも学習してみました。
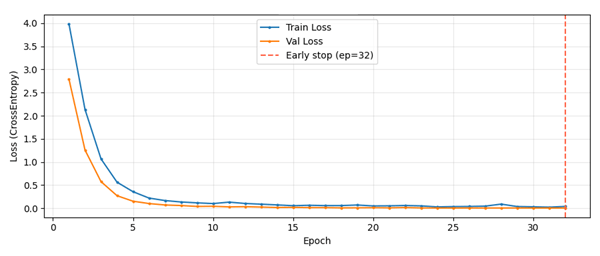
結果はMean Accuracy 99.95%と、画像分類としては上限に近い数字が出ました。DMLのときもそうですが、これだけ高い精度が出た要因としては、
- 同一撮影条件の同一個体だった
- テストサンプルが少ない(6枚 / クラス)
- ResNet18には簡単過ぎた
等があるかと思います。
しかし両者の本質的な違いは精度ではなく、何ができるかで、その違いを改めてまとめると以下のようになります。
| CNN(画像分類) | DML(距離学習) | |
|---|---|---|
| タスクの性質 | クローズドセット | オープンセット |
| 未知クラスの判定 | 無理やりどれかに分類してしまう | 距離が遠い=未知と判断できる |
| 新クラスの追加 | 再学習が必要 | DBにベクトルを追加するだけで対応可能 |
| 出力 | Softmax確率 | 空間上のL2距離(類似度) |
確認のため、ここで学習したCNNに上でDMLに見せたのと同じ未知薬剤の画像を見せてみました。
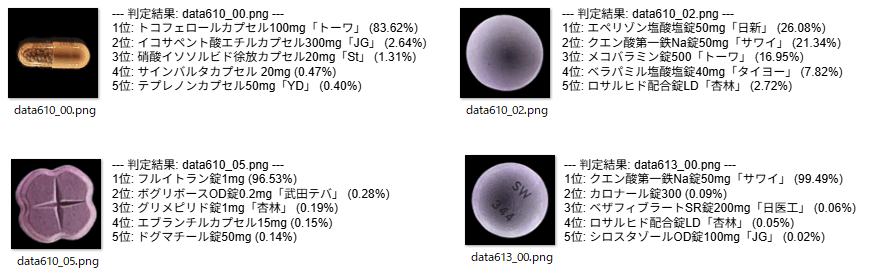
もちろん正解は知らないので、どれもデータセットにあった色や形が近い知っているどれかを返してきます。確率が割れているものもありますが、自信満々で間違えているものもあります。
一方、DMLでは別のものとされた右下のデザイン変更品については正しいラベル名を返すことができました。
AIによるアドバイスが大きかったですが、薬の識別システムという、毎月のように種類がどんどん増え、間違いは極力避けなければならない(より安全側の設計が求められる)というタスクにおいては、やはりDMLというアプローチが最適だったと納得しました。
緑色の光で刻印はより鮮明になるか
これはある時、掃除機をかけているときに(・・これ、なんで緑色なんだろう?)と思ったことがきっかけです。下画像のような掃除機です。

システムを作ってだいぶ経っていましたが、撮影時のLEDで試すとどうなるのか興味が湧きました。
ネットで検索したメーカー(ダイソン)のページでは
人間の目は、緑色の光への感度が高くなっています。緑色は他の色よりも明るく感じられるためコントラストが高まり、見えにくいホコリがはっきり見えるようになります。
と書かれてありました。
次にAIに応用できるかを聞いてみると
可能性はあります。 緑の光だけを当ててGチャンネルを抽出したときが、最も画素の密度が高く、ノイズが少なく、ピント(エッジ)がカリッと合います。偶然の着眼点ですが、理にかなっています。
とのことで、実際にやってみることにしました。
変えたのはラズパイの撮影設定のみで、PC側の刻印強調処理は触っていません。
(255, 240, 230) → (0, 125, 0) # LED白から緑へ. (0, 255, 0)では明るすぎたため125に
"--awbgains", "0.7, 0.5"  # "1.8, 1.0"から変更
"--saturation", "0.0"  # 1.4から変更
結果を数値とグラフで比較・確認しました。
結論から言うと、今回の条件では白色LEDでの撮影と変わりありませんでした。
ラプラシアン分散(エッジの鮮明度)の比較では緑LEDが+16.7%となりましたが、
刻印部分を横切る直線(赤線)上の輝度グラフ(下図)ではほぼ同じです。
AIに聞いたところ、ラプラシアンでは緑にした際にコントラストが跳ね上がり、ノイズが増えたせいで数値が上がっただけなのでは、とのことでした。ハード(センサー等)的なものなのか、パラメータの設定なのかはわかりませんが、この試みはこれで断念しました。

光源の角度を変えてみる
刻印強調に最も効果がありそうだったのは、LED光の当てる角度の調整です。
LEDテープをこれまでの位置よりもさらに2~3mmほど下にずらして貼り直してみました。
変更する前と同じ状態のシャーレを撮影することができないので、上のようなグラフは描けませんでしたが、アップで見てみると目視でもLED位置変更後(右側)の方が刻印がよりはっきりしているように見えます。
もちろん、撮影設定・4枚合成のコードは位置変更前と全く同じものにした上、シャーレ上の錠剤の位置、向きもできるだけ変更前のものと同じになるよう合わせて撮影しています。
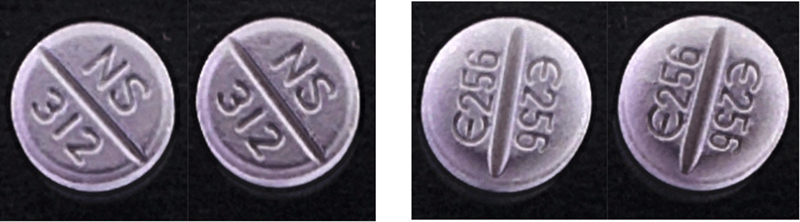
刻印強調を探っていくならこの調整が効きそうでした。
おわりに
機械学習(ディープラーニング)を使って薬の識別ができないか、という思いから始まり、ハード、データセットの作成、モデルの学習、物理性状フィルタの組み込み、そしてUIまで一通りのシステムを自作してみました。
これが実際の運用で通用するものになると、数千種類のデータセットやより厳密なカメラ環境が必要になりますが、いろいろ試行錯誤していくうちに新しい知見を得ることもできて個人的にはなかなか満足のいく試みでした。また面白そうなことがあったら記事にしていきたいと思います。
